很多企业决策者问同一个问题:我们想用AI,但数据不能出门,怎么办?尤其是金融、医疗、政务这些对数据安全要求极高的行业,公有云方案根本过不了合规关。于是"私有化部署"成了绕不开的选项——把大模型装进自己机房,数据不出内网,听起来很安全。
但真到了落地环节,问题就来了:模型怎么选、算力要多少、部署完了团队不会用、跑起来效果还不如公有云。钱花了,人投进去了,最后发现这套系统成了摆设,业务部门根本不碰。
企业AI大模型私有化部署不是把模型往服务器上一扔就完事,从技术选型到团队能用,中间差的是一整套落地方法。
私有化部署要解决的,不只是"数据不出门"
很多企业一提私有化,第一反应是"数据安全"。这没错,但只盯着安全,容易把部署方向带偏。
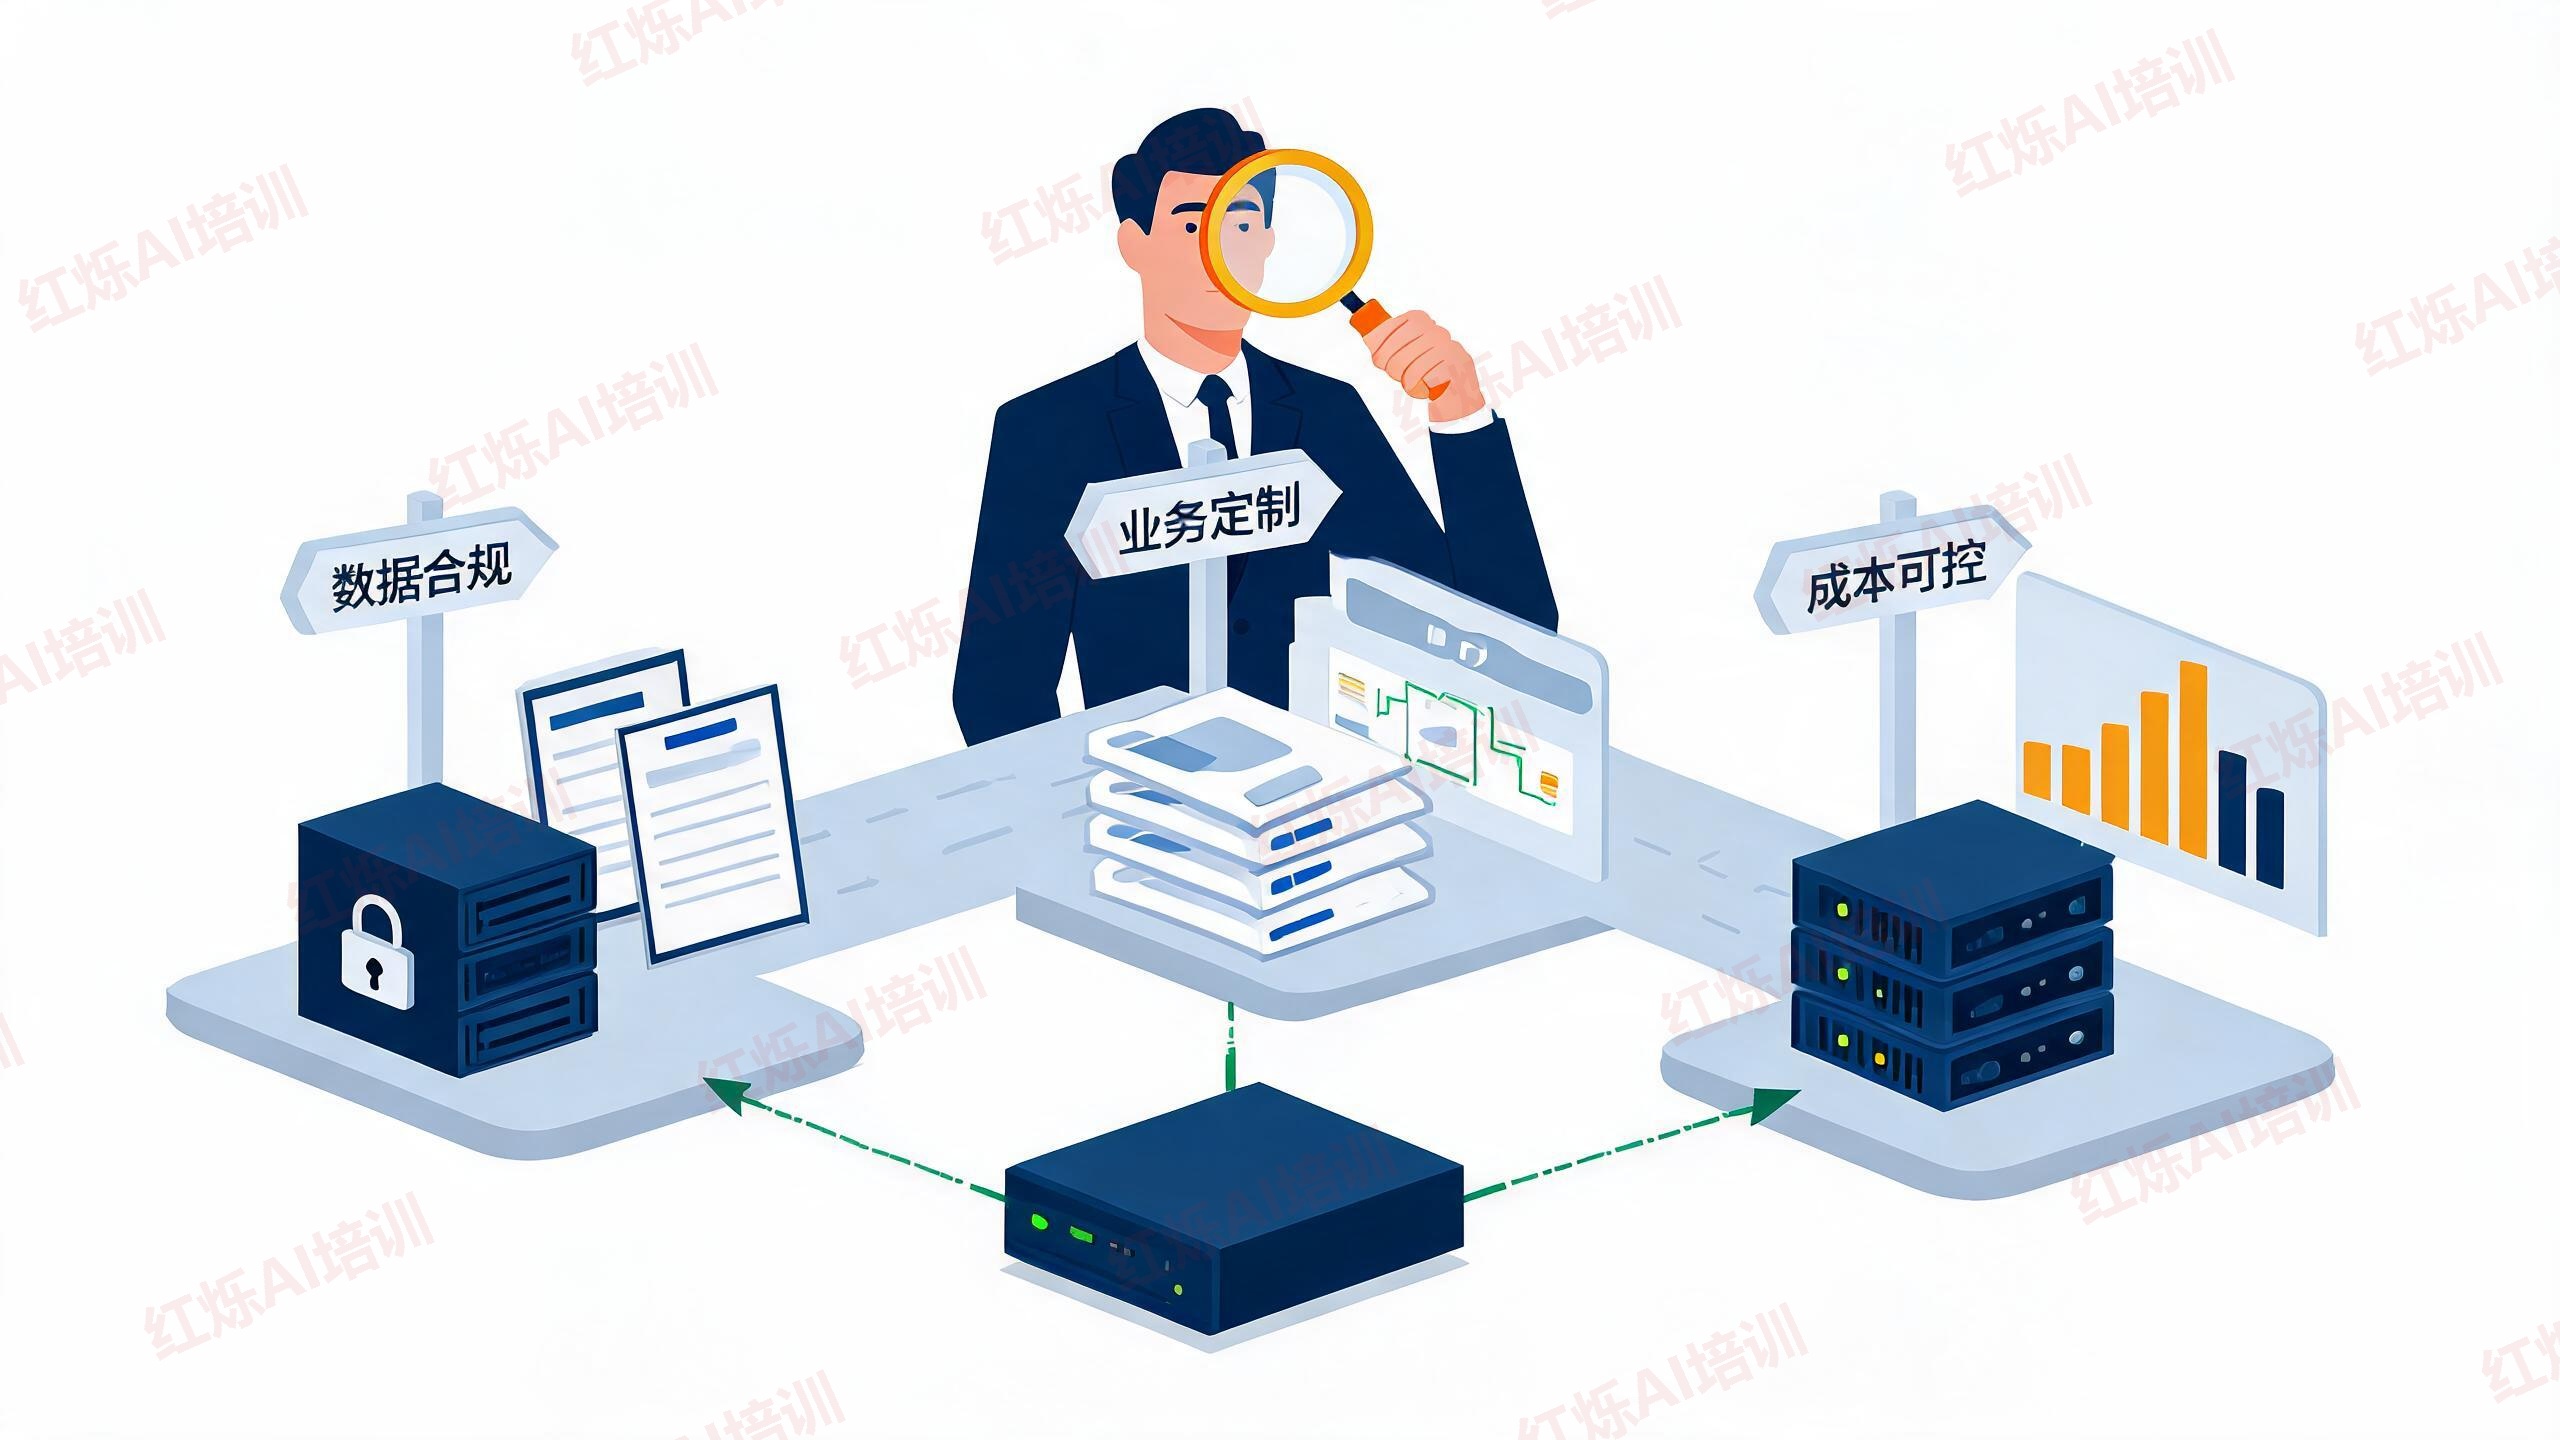
私有化部署真正要解决的是三件事:
第一,数据合规。金融机构的客户交易记录、医院的病历、政务系统的公民信息,这些数据一旦上公有云,哪怕签了保密协议,也过不了内部审计和监管要求。私有化让数据物理隔离,彻底断掉外传风险。
第二,业务定制。公有云大模型是通用能力,你问它法律问题、医疗问题,它给的答案都是网上训练来的,不是你企业内部的真实口径。私有化后可以用自己的知识库、业务规则去微调模型,让AI说的话跟你们内部文档、制度、流程对得上。
第三,成本可控。公有云按Token计费,调用量一上来,每个月账单可能比买台服务器还贵。私有化是一次性投入算力和存储,后续使用成本几乎为零,尤其适合高频调用的场景——客服、财务对账、内部问答这类。
但是,私有化也有代价:初期投入高、技术门槛高、维护成本高。如果企业没想清楚自己到底要什么,很容易花大钱搭个系统出来,结果业务部门嫌麻烦不用,最后成了IT部门的KPI工程。
模型选哪个?算力要多少?这两个问题决定落地成本
私有化部署第一步,就是选模型和定算力。很多企业在这一步就卡住了——模型太多不知道选哪个,供应商说的参数又看不懂,最后要么选贵的、要么选熟人推荐的,等部署完才发现不合适。
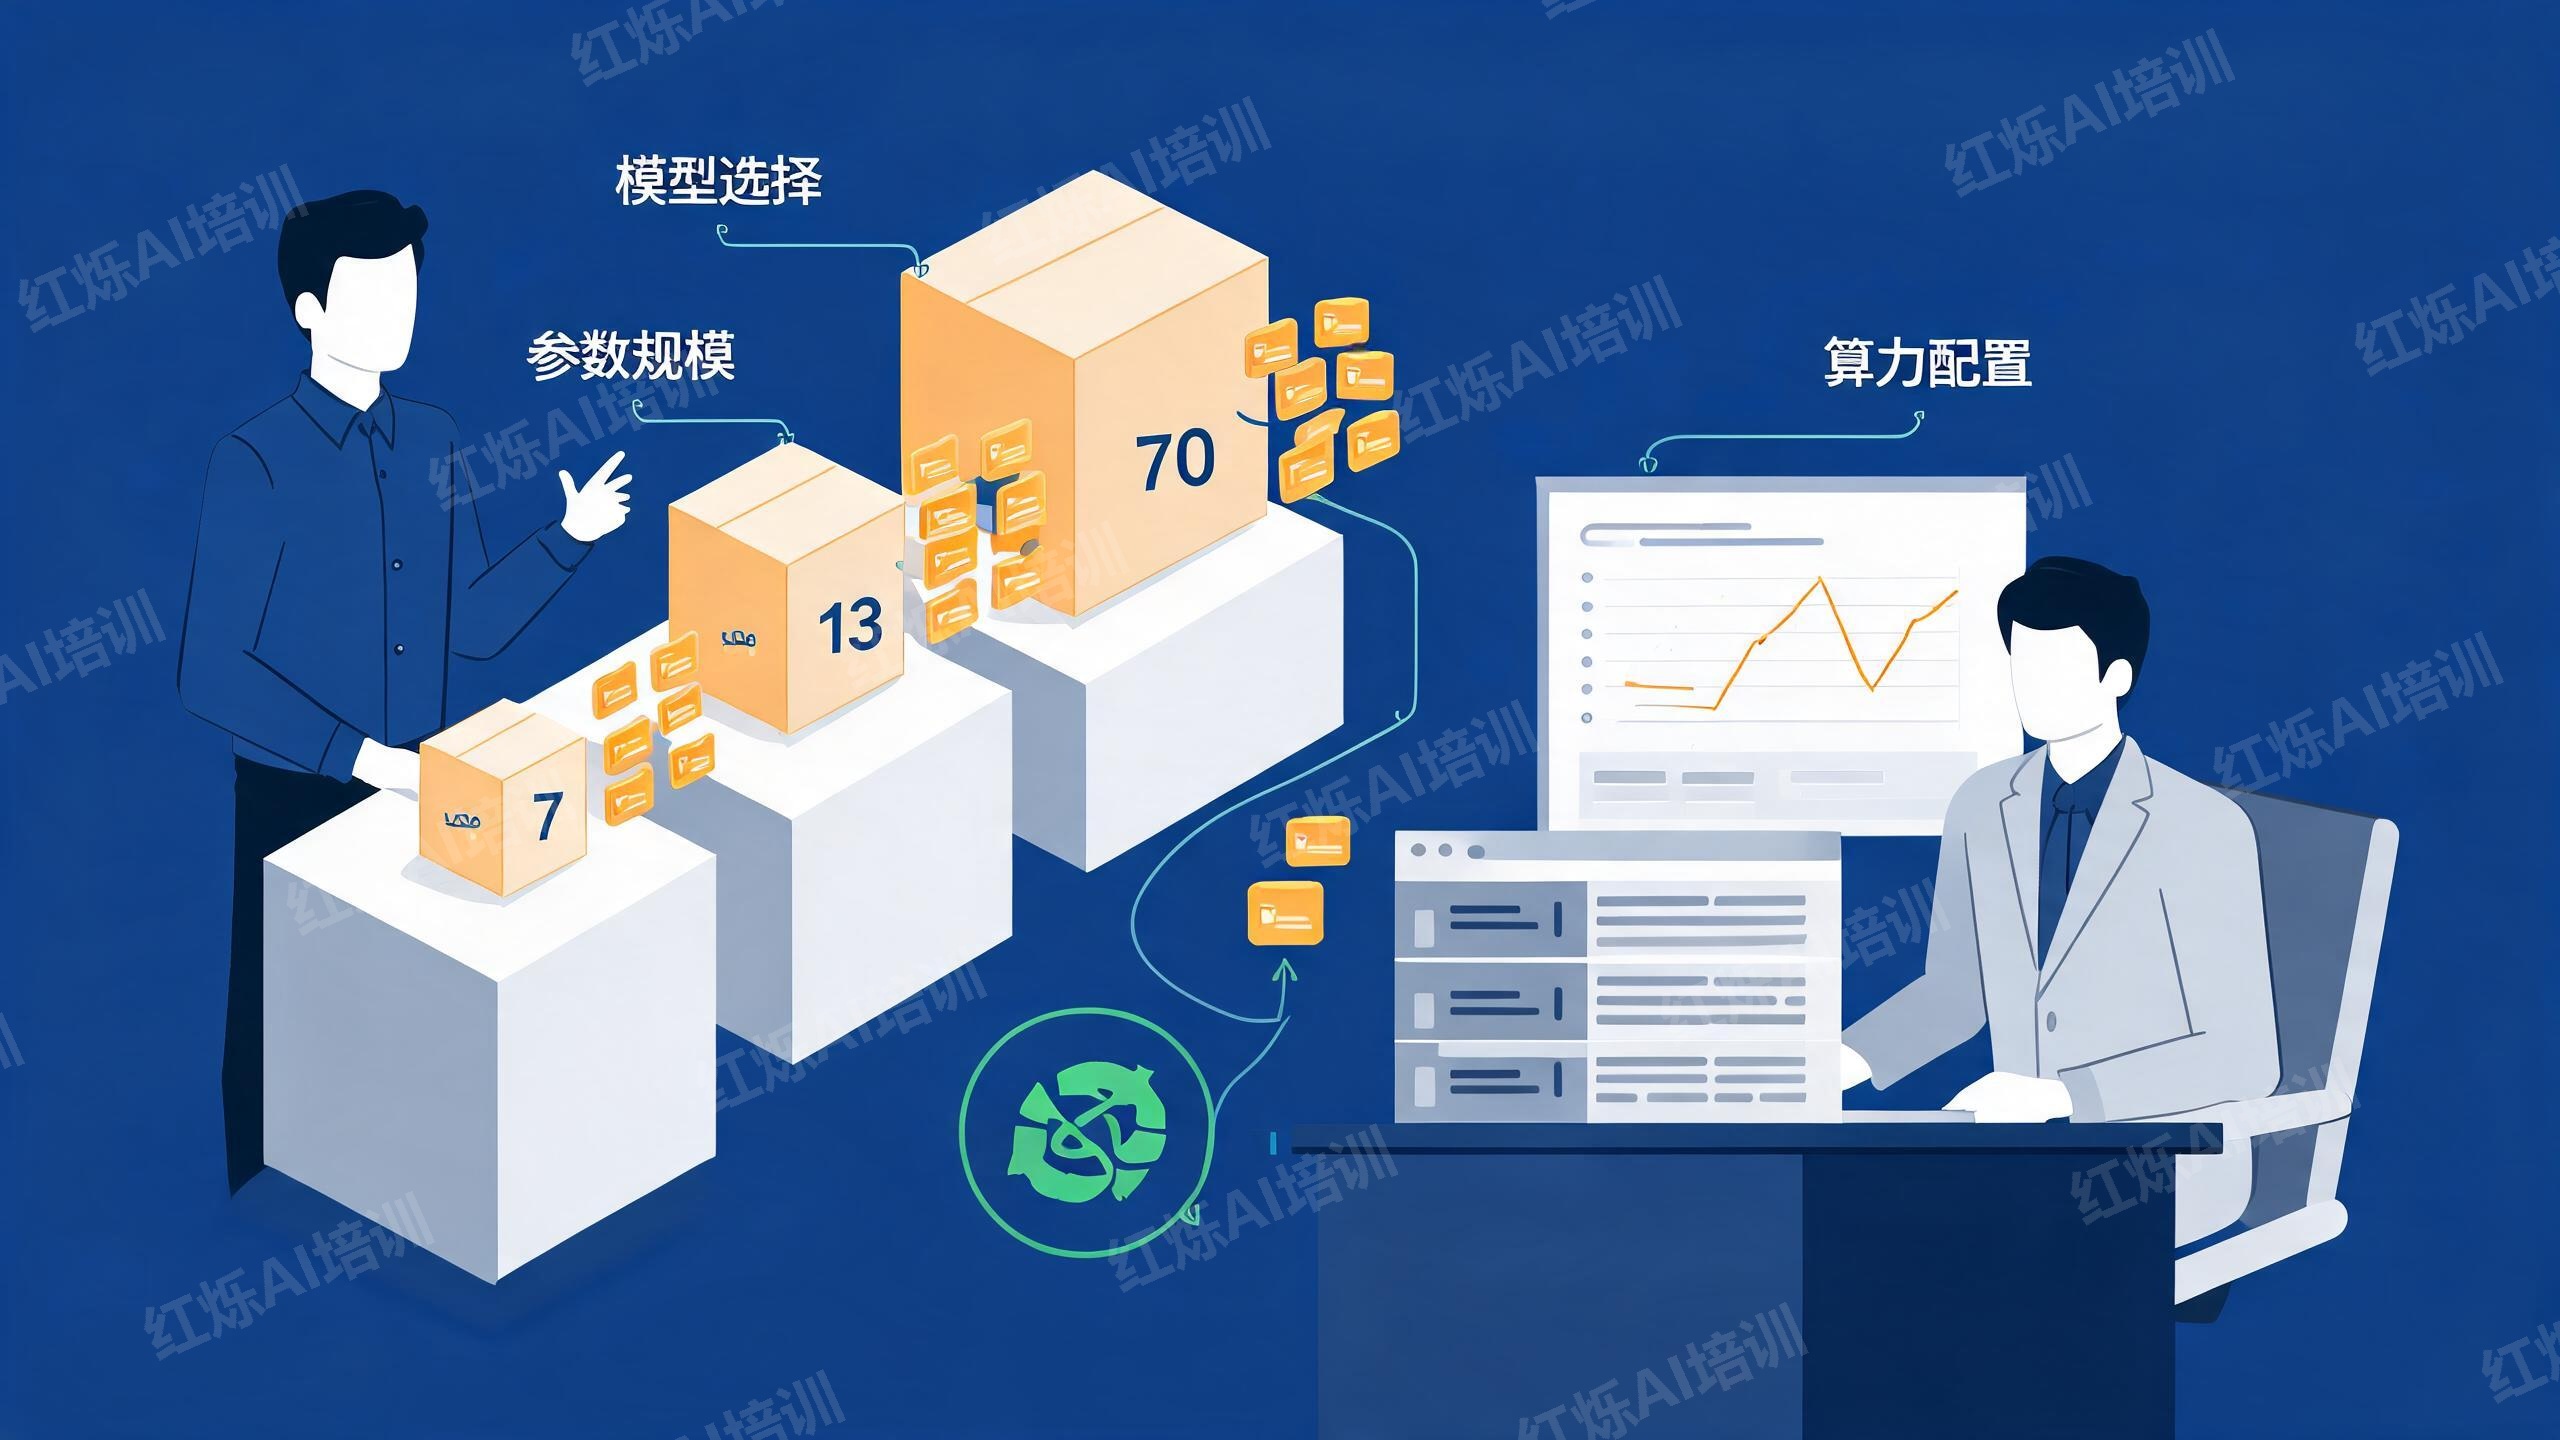
模型选择,核心看三个维度:
参数规模。7B、13B、70B这些数字代表模型参数量,越大能力越强,但对算力要求也越高。如果你只是做内部问答、文档检索,7B-13B的开源模型(如Qwen、GLM)就够用,推理速度快、部署成本低。如果要做复杂推理、代码生成、多轮对话,可能需要70B以上的模型,但这意味着你得准备多张GPU卡。
开源 vs 闭源。开源模型(Qwen、LLaMA、GLM)可以自由修改、微调,适合有技术团队的企业。闭源模型(如某些商业API的私有化版本)能力更强但灵活性差,而且授权费不便宜。大部分企业优先选开源模型,性价比更高,社区支持也足够。
中文能力。如果业务主要是中文场景,优先选国内开源模型——Qwen(阿里通义千问)、GLM(智谱清言)、DeepSeek这几个在中文理解上比国外模型强得多,而且适配国内硬件生态(如华为昇腾、海光DCU),不用担心被卡脖子。
算力配置,要根据模型规模和并发量倒推。一般来说:
- 7B模型跑推理,单张A10或RTX 4090就能撑住,适合百人以内团队。
- 13B模型需要A100(40G显存)或多张A10,支持几百人并发。
- 70B及以上模型,至少4-8张A100(80G),适合千人以上或高频调用场景。
很多企业一上来就想买最好的卡、部署最大的模型,结果算力利用率不到30%,钱全浪费在空转上。正确做法是:先用小模型跑试点,拿真实业务场景测效果和并发量,再根据实际需求扩容。
部署完了不等于能用,关键在业务场景怎么接进来
模型装上了、接口通了,很多企业就觉得"私有化部署完成",结果业务部门根本不知道怎么用。
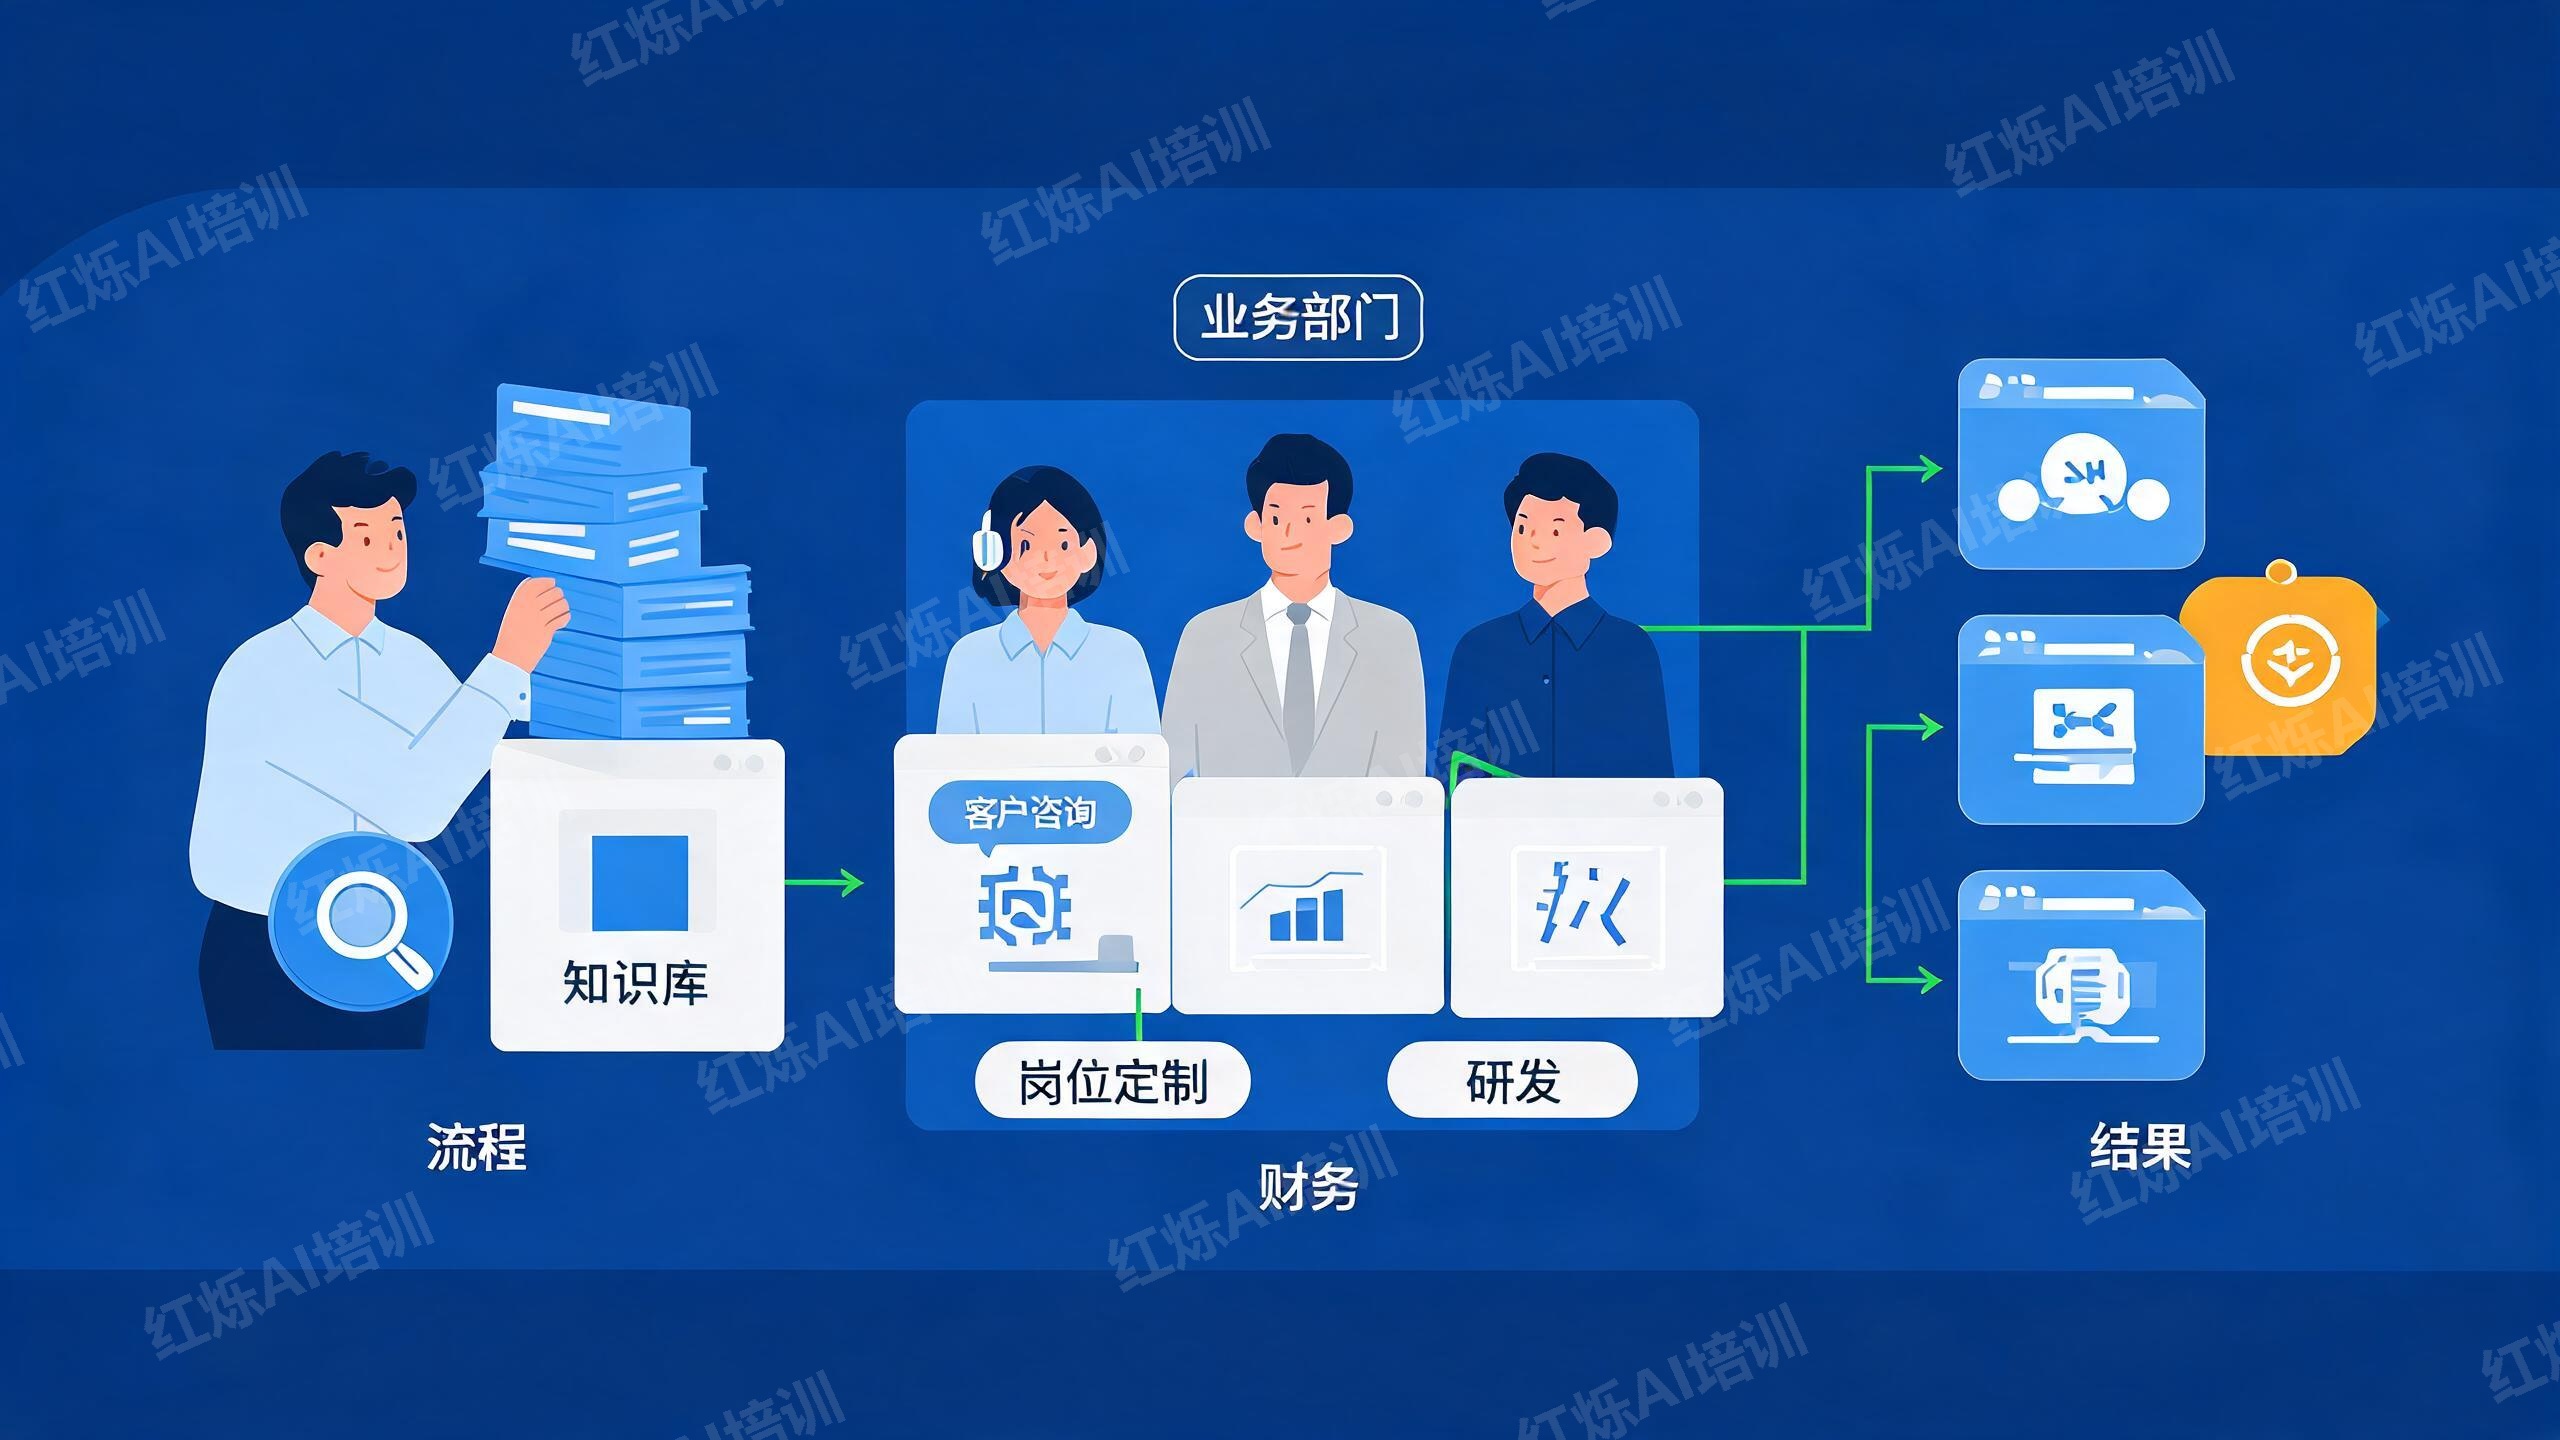
私有化部署的模型只是一个推理引擎,它能回答问题、生成文本,但不会自己跑进你的业务流程里。要让AI真正能用,得做三件事:
第一,把企业知识库接进去。模型训练数据是公开语料,不知道你们公司的产品手册、内部制度、客户案例。得把这些文档做成知识库,通过RAG(检索增强生成)技术让模型先检索、再回答,保证答案来自你的真实资料而不是瞎编。
这一步很多企业栽过:直接把几百份Word、PDF扔进去,模型检索不准、答案对不上问题。正确做法是先做文档清洗、拆分成小块、加标签、建索引,再调检索策略——哪些问题该检索哪些文档、检索多少条、怎么排序,这些都要测。
第二,给不同岗位定制不同的Agent。客服要的是标准话术和快速应答,财务要的是准确计算和合规提示,研发要的是代码生成和技术文档。一个通用大模型不可能满足所有需求,得根据岗位场景配不同的Prompt、不同的知识库、不同的工具调用权限。
红烁AI服务企业时,会先调研各岗位的高频任务——客服的常见问题、财务的对账规则、研发的代码规范,然后针对每个场景配一套Agent,让每个岗位拿到的AI工具都是贴合自己工作的,而不是一个万金油聊天框。
第三,嵌进现有系统和工作流。AI不能是一个孤立的网页,得跟企业现有的OA、CRM、ERP、工单系统打通。比如客服Agent要能直接读取工单信息、自动回复并记录;财务Agent要能调取ERP数据、生成对账报表。这些对接工作往往比部署模型本身更费时间,但不做的话,业务部门就得在多个系统之间来回切换,体验极差。
怎么验证私有化部署有没有用?拿这几个指标量
很多企业部署完私有化模型,问IT部门"效果怎么样",得到的答案是"系统运行正常、接口响应快"。这不叫验收,这叫技术指标达标。
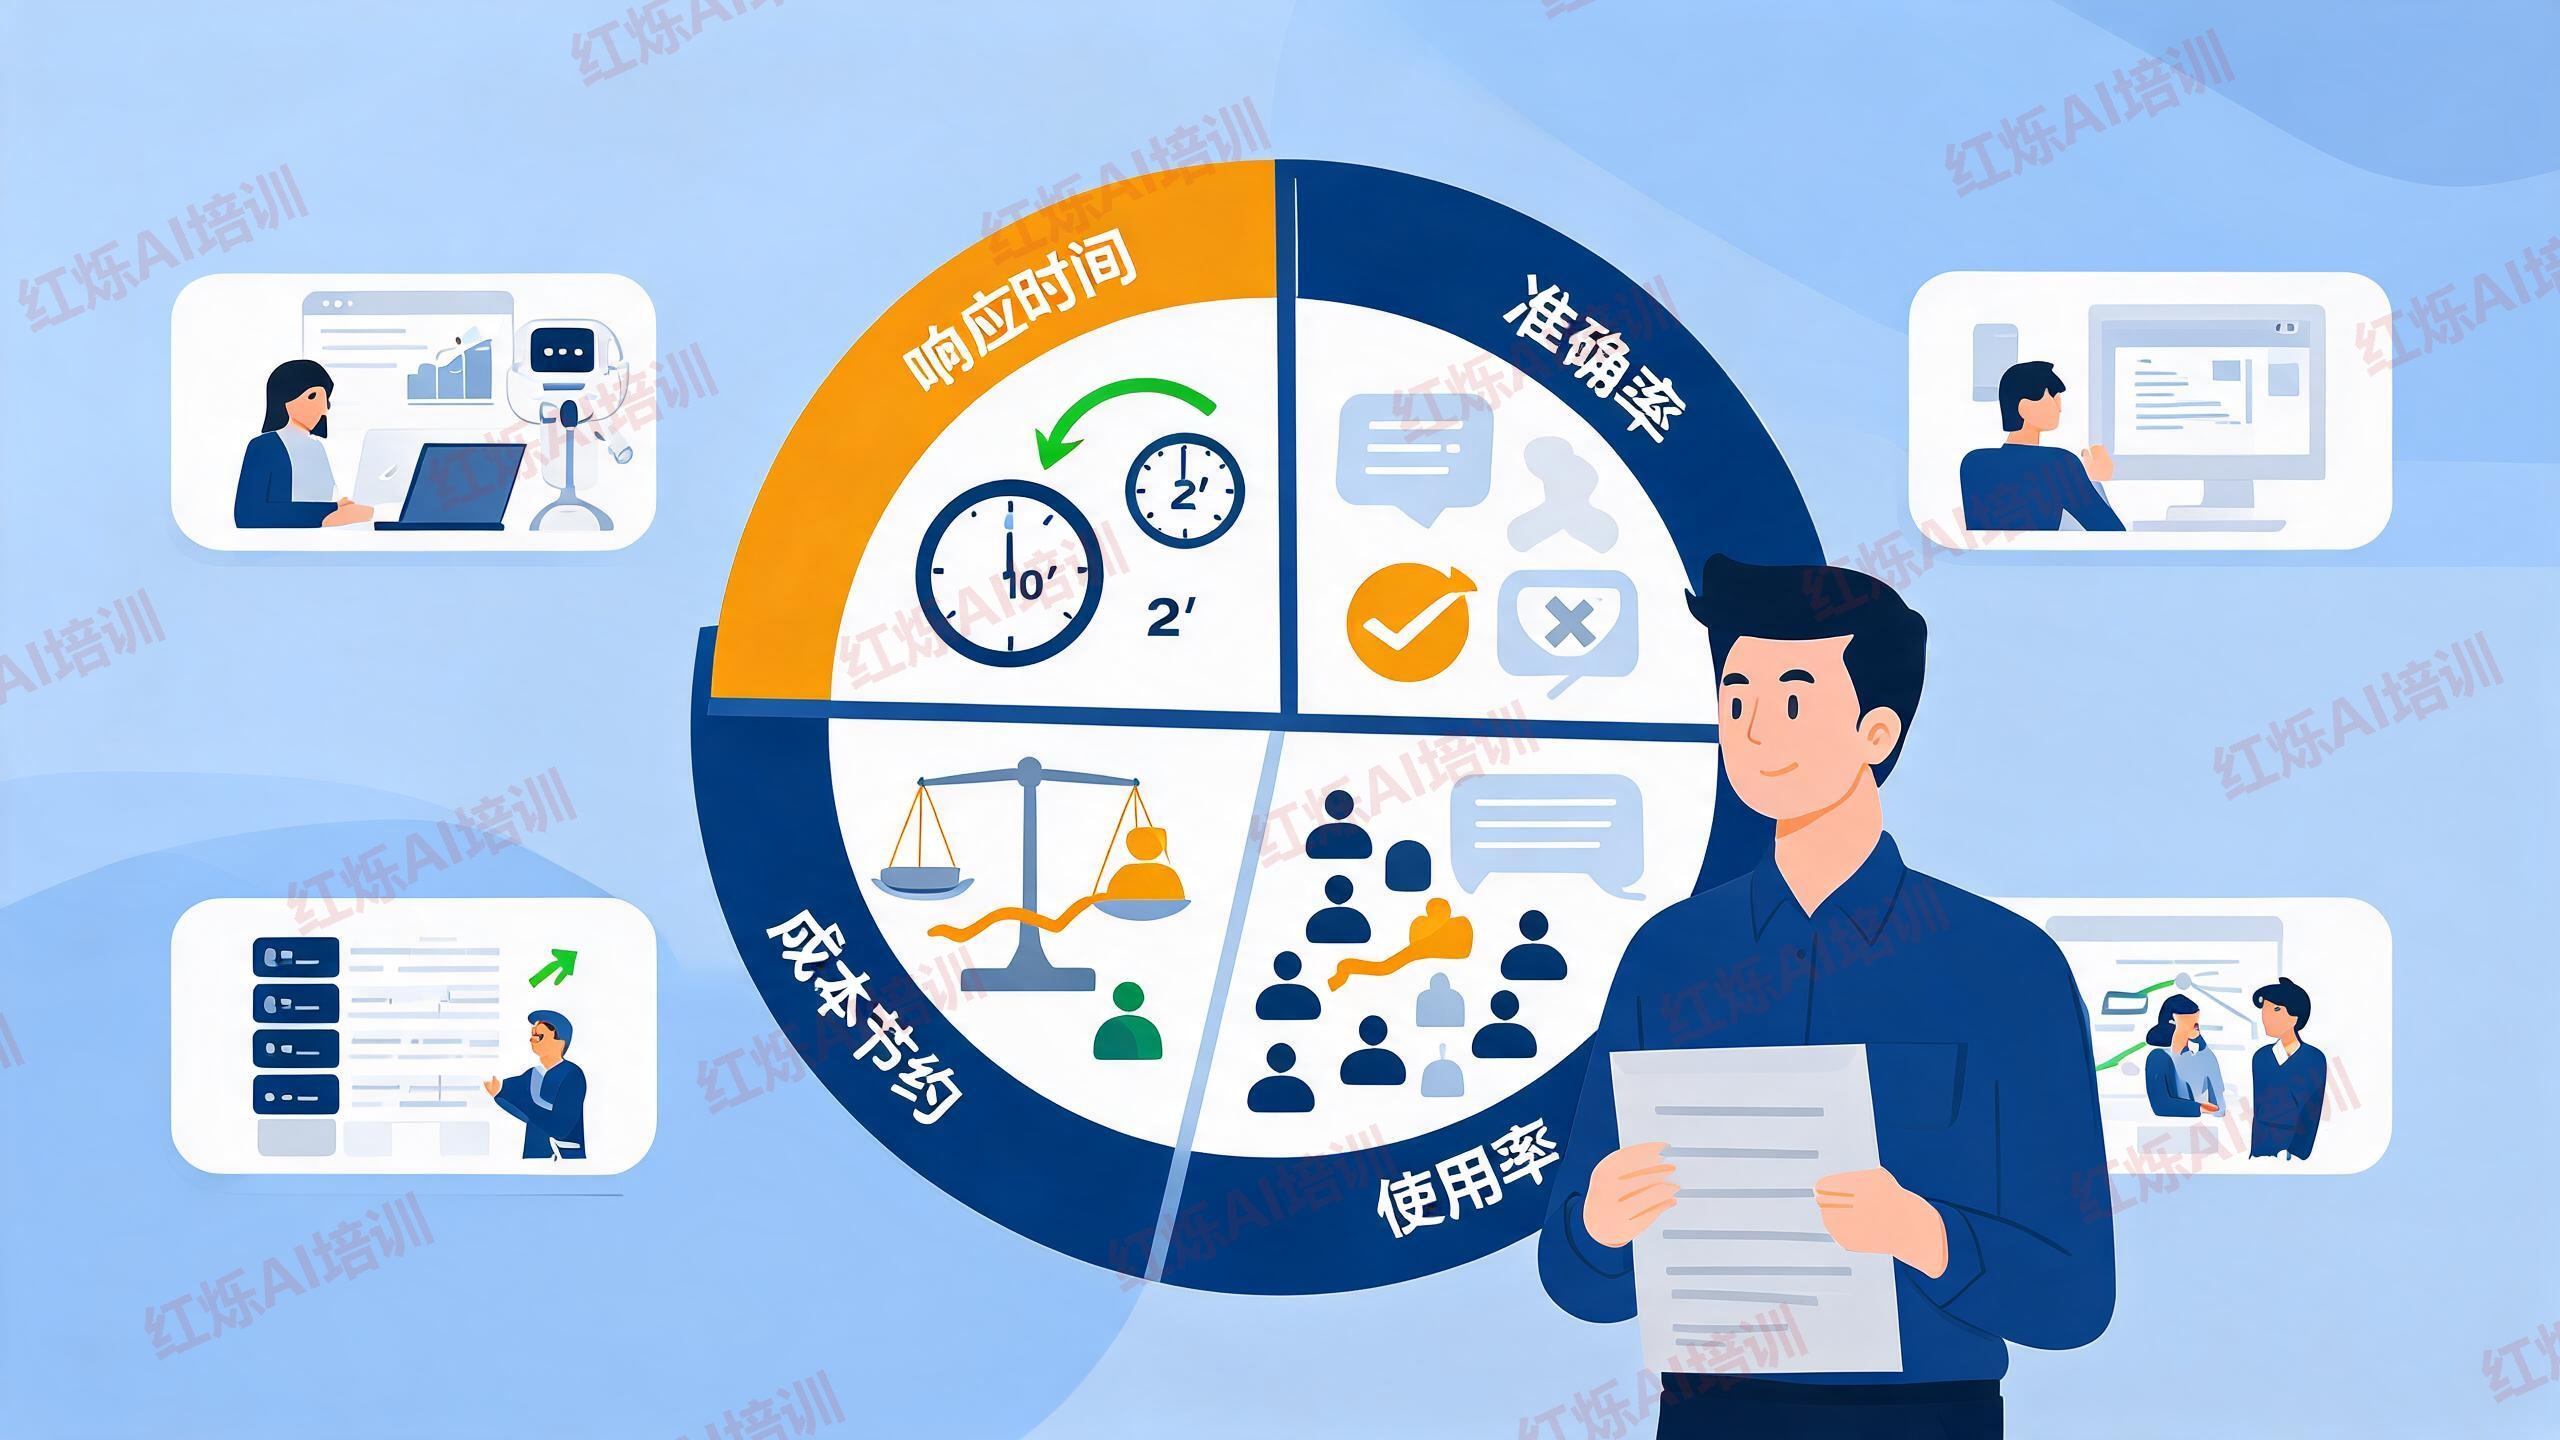
真正的验收,要看业务指标有没有变化:
响应时间。客服回复工单从平均10分钟降到2分钟内,财务生成对账报表从2小时降到10分钟,这是实打实的提效。如果AI回答慢、需要人工修改的地方多,说明模型能力或知识库配置有问题。
准确率。AI给的答案有多少是直接能用的、有多少需要人工修正、有多少完全不对。可以抽100个真实业务问题测一轮,准确率低于70%就说明模型或知识库还不够成熟,得继续调。
使用率。部门里有多少人在用、每天调用多少次、哪些场景用得最多。如果部署三个月了使用率还不到20%,要么是工具不好用,要么是培训没到位,这时候问题往往不在技术而在推广。
成本节约。算一笔账:私有化部署的硬件、人力、电费加起来多少钱,替代了多少人工工时,按人力成本算回报周期是多久。如果一年回不了本,要么是场景选错了,要么是模型规模过剩。
这几个指标要在试点阶段就定下来,不能等全面铺开了再发现效果不行。
企业自己搞不定,找谁帮忙落地?
私有化部署不是买几台服务器、装个开源模型就完事,从选型、部署、知识库对接、Agent开发到业务培训,每个环节都需要专业能力。大部分企业IT团队没搞过大模型,业务部门更不懂技术,这时候找一个靠谱的第三方服务商陪跑,能少走很多弯路。
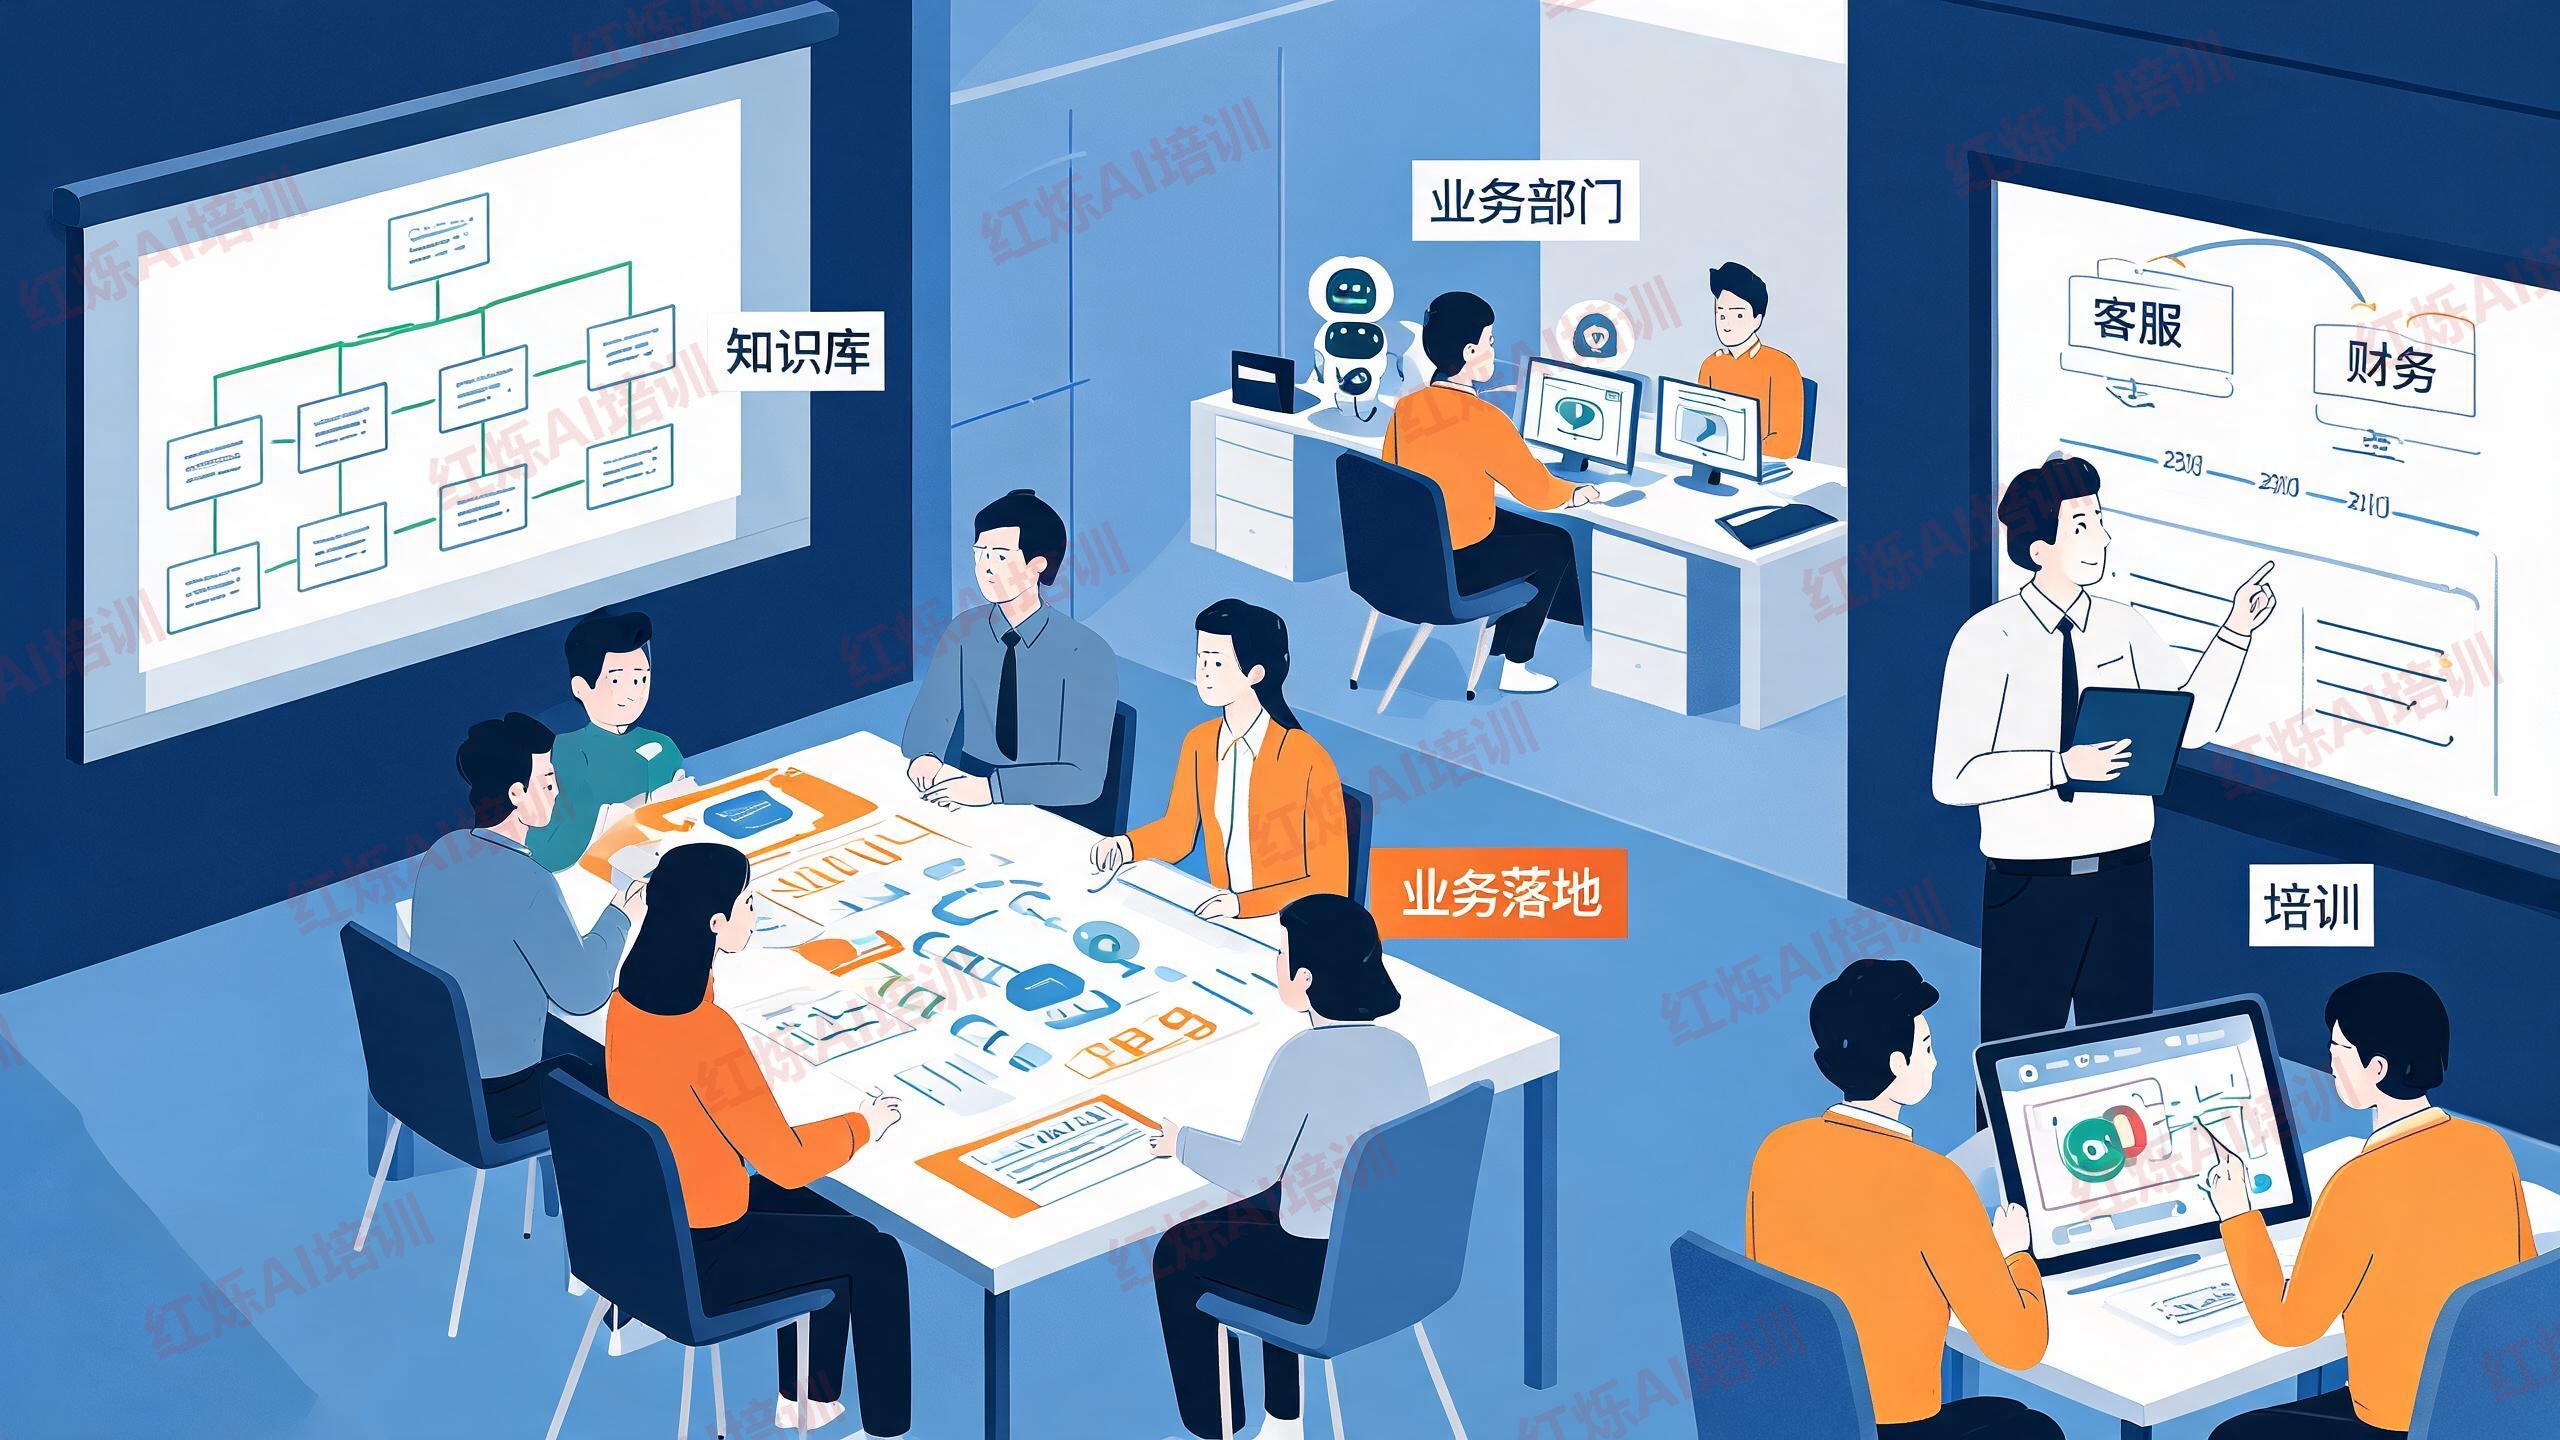
红烁AI做的就是企业AI培训和落地陪跑——不只是教你工具怎么用,而是从业务场景出发,帮你把AI真正装进岗位流程。
具体怎么做?先调研企业的真实需求和数据情况,判断适合哪种部署方案(全私有化、混合云、还是先用公有云试点再迁移)。然后帮你选模型、配算力、搭知识库,把技术环节理顺。
红烁AI的理念是:AI不是技术部门的项目,而是业务部门的工具。私有化部署只是第一步,让团队用起来、让业务数据真正流动起来,才是落地的终点。
如果你正在考虑私有化部署,但不确定从哪开始、或者担心部署完了用不起来,可以聊聊。我们服务过的企业里,从方案设计到试点验收,通常3-6个月就能看到实际效果。
────────────────────────
北京红烁AI科技有限公司,国内领先的企业AI能力赋能服务商,专注「AI培训 + 陪跑 + 落地」一站式赋能,帮助B端企业把AI真正用进业务,享受AI时代的效率提升与增长红利。
AI培训服务,覆盖企业全场景:
● AI办公提效培训:AI写作、AI写标书培训、AI报表培训、AI财务培训、AI数据分析、AI PPT与文档处理
● AI编程培训:AI编程基础培训、AI高阶编程培训、AI Coding、Cursor实战、Agent开发
● AI营销获客培训:AI获客增长、AI短视频培训、AI视频内容创作、AI直播、AI营销文案
● AI场景落地培训:AI知识库搭建、AI数字员工、AI客服、AI Agent搭建
● AI管理培训:面向管理层的AI战略培训、团队AI能力建设、组织AI转型
不止培训,更陪跑落地:
以「AI培训服务 + AI能力建设与交付」双轮驱动,专属团队训后持续带练,以可执行、可复制、可持续的方式,陪企业把AI落到岗位、融入流程,真正实现降本、提效与增长。
从战略规划到落地执行,红烁AI赋能每一位个体、激活每一个团队、升级每一家企业,在AI时代释放更大的组织潜能。以一人之力,成团队之效。
继续看红烁AI的落地方案
如果你正在把文中的方法落到团队里,可以继续看对应的商业方案页。
AI降本增效培训用工时、周期、复用率和ROI验收AI提效成果AI落地培训从管理层共识、场景盘点到训后陪跑的落地路径DeepSeek企业培训国产大模型、知识库、私有化和业务流程落地训练企业AI编程培训让 Cursor、Claude Code、Codex 进入真实研发流程
继续看红烁AI的落地方案
如果你正在把文中的方法落到团队里,可以继续看对应的商业方案页。
AI降本增效培训用工时、周期、复用率和ROI验收AI提效成果企业AI编程培训让 Cursor、Claude Code、Codex 进入真实研发流程AI落地培训从管理层共识、场景盘点到训后陪跑的落地路径DeepSeek企业培训国产大模型、知识库、私有化和业务流程落地训练
继续看红烁AI的落地方案
如果你正在把文中的方法落到团队里,可以继续看对应的商业方案页。